Prospection IA : ce que c'est, ce que ça coûte, ce que ça produit.
Six étapes, un rôle précis pour l'IA à chacune, les tarifs publics du 12 octobre 2026 et ce qu'il faut mesurer pour juger le résultat.
 Martin GirardGTM Engineer indépendant
- Publié
- 12 octobre 2026
- Mis à jour
- 12 octobre 2026
- Lecture
- 18 min

La prospection IA consiste à confier à des modèles de langage les tâches de jugement d’une campagne de prospection : repérer un signal, qualifier une entreprise, choisir l’interlocuteur, adapter un e-mail, classer une réponse. Le reste relève de l’orchestration.
Ce texte décrit les systèmes que nous exploitons chez des PME françaises : les six étapes, le rôle exact de l’IA à chacune, ce que chaque poste coûte aux tarifs publics relevés le 12 octobre 2026, et ce qu’il faut mesurer pour juger un résultat.
Qu’est-ce que la prospection IA.
Un détail sépare la prospection IA de l’automatisation classique. Un scénario Zapier exécute une suite d’actions déterminées à l’avance sur des données déjà structurées. Un pipeline de prospection IA appelle un modèle aux endroits où la donnée est du texte libre et où il faut trancher : ce profil correspond-il à notre cible, cette adresse appartient-elle bien à cette entreprise, cette réponse est-elle un refus ou un message d’absence.
Agent IA, automatisation, pipeline
Un agent décide seul de l’ordre de ses actions à partir d’un objectif. Nos systèmes fonctionnent autrement : l’ordre des étapes est fixé, et le modèle intervient dans des cases précises avec une sortie imposée. Ce choix pèse directement sur l’exploitation. Lorsqu’une campagne dérape, nous savons quelle étape a produit quoi, car chaque verdict est écrit en base avec l’identifiant du prospect. Une architecture d’agent libre rend ce diagnostic beaucoup plus difficile, et nous expliquons cet arbitrage dans notre architecture n8n pour la prospection.
Les six étapes, et l'IA dans chacune
- Le signal.
Apify extrait les offres d’emploi (
misceres/indeed-scraper), les profils LinkedIn (harvestapi/linkedin-profile-search) et les fiches Google Maps (compass/crawler-google-places). Pour les entreprises à céder, la liste part des registres publics SIRENE et BODACC. Jina Reader lit les sites des entreprises : page d’accueil, catalogue, page contact. L’IA intervient ici pour lire ce qui n’est pas structuré. - La qualification.
Le modèle lit la source en entier (profil, offre d’emploi ou site) et rend un verdict binaire avec le nom du signal détecté. Claude Haiku 4.5 tient ce poste, température 0, sortie JSON stricte.
- Le contact.
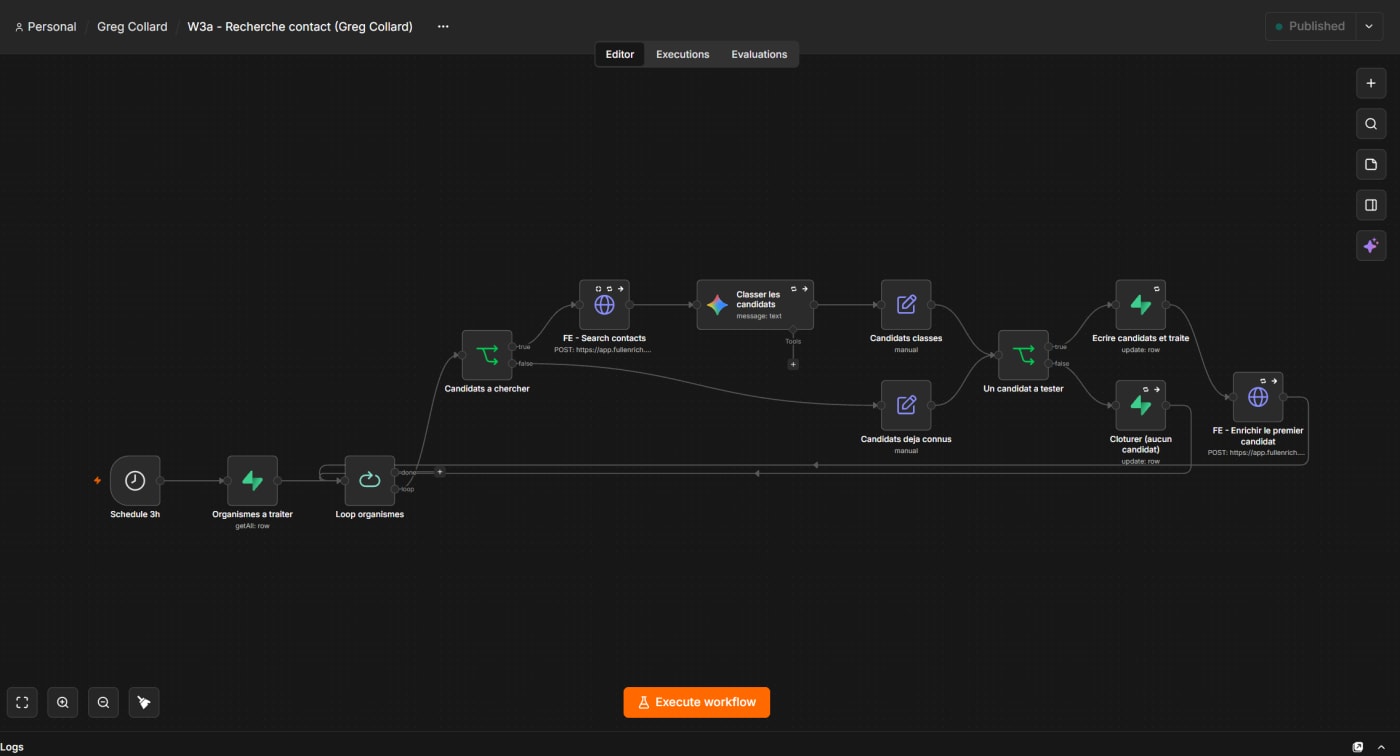
FullEnrich cherche l’e-mail. Le modèle classe les candidats retournés et désigne celui à tester en premier, puis vérifie la cohérence du domaine obtenu.
- La rédaction.
Deux appels distincts : un modèle rapide pour l’objet, un modèle intermédiaire pour le corps. Nous utilisons les modèles Claude, Gemini et Mistral selon la difficulté de la tâche.
- L'envoi.
n8n orchestre l’ensemble, les boîtes tournent sur des domaines secondaires, Smartlead chauffe un domaine neuf, Unipile gère le canal LinkedIn dans un second temps.
- Les réponses.
Le code associe le message au contact, puis le modèle classe son contenu en six catégories.
Si vous découvrez le sujet, notre guide de la prospection automatisée pour PME reprend ces six étapes du point de vue d’un dirigeant qui doit décider.
Cibler : l’IA lit ce qu’un filtre ne lit pas.
Un signal daté vaut mieux qu’un critère permanent
Un code NAF et une tranche d’effectif décrivent un état. Une offre d’emploi publiée depuis moins de quinze jours décrit un besoin en cours. Pour cibler les entreprises qui recrutent, le scraping s’exécute toutes les nuits sur une liste de vingt-deux intitulés de poste, avec une comparaison par URL : seules les nouvelles offres sont enregistrées dans la base.
Un relevé a modifié notre manière de dédoublonner. 95 % des nouvelles offres venaient d’entreprises déjà présentes en base. Une entreprise qui recrute des conducteurs republie en continu. Le dédoublonnage s’effectue donc par entreprise, et l’e-mail cite l’offre la plus récente, ce qui évite de recontacter la même société à chaque nouvelle annonce.
Pour cibler les entreprises à céder, la liste est construite selon des règles appliquées aux registres publics : âge du dirigeant, ancienneté du mandat, mandat unique, absence de successeur familial probable repérée dans ses SCI. Chaque matin, les entreprises cédées, radiées ou passées en procédure la veille sortent de la file. L’API publique des entreprises plafonne à 10 000 résultats par requête, ce qui oblige à découper la recherche par département et par secteur. Parmi les 50 554 entreprises réunies dans la base, 3 792 sont ressorties éligibles après application des filtres.
Exclure d’abord ceux qui parlent du sujet sans acheter
La première tâche du modèle de qualification est d’écarter, et non de retenir. Pour cibler des repreneurs, la règle d’exclusion principale vise les prestataires du marché de la reprise, reconnaissables à un profil rédigé pour attirer des clients. Ces profils parlent de reprise d’entreprise en permanence et ne seront pas acheteurs. Un mot-clé booléen les ramène tous ; une lecture complète du parcours les exclut.
Même logique pour les signaux faibles. Une transition professionnelle ne compte que si la personne a déjà dirigé une activité dont elle portait le compte de résultat. Sans cette condition, le pipeline se remplit de consultants entre deux missions.
Voici la forme de l’appel de qualification, à observer pour deux choses : la liste fermée de règles et la consigne en cas de doute.
{
  "model": "claude-haiku-4.5",
  "temperature": 0,
  "max_tokens": 150,
  "sortie_attendue": {
    "id_profil": "recopie caractere pour caractere, sert de cle de jointure",
    "verdict": "retenu | rejete",
    "signal": "un seul nom pris dans la liste fermee",
    "exclusion": "nom de la regle si une exclusion a prime"
  },
  "regles": [
    "transition professionnelle seule -> rejete",
    "transition + direction avec responsabilite de P&L -> retenu",
    "formulation tournee vers un client -> exclusion prestataire, prime sur tout",
    "doute -> rejete"
  ]
}
Deux filtres, le second rejette par défaut
Pour cibler des organismes de formation, nous avons mis en place deux étapes successives. Un tri large d’abord, sur le registre public. Une extraction stricte ensuite doit récupérer l’intitulé exact de la formation qui correspond à l’offre du client, et rejette les cas où elle n’en trouve pas. Sur les 4 128 organismes en base, 389 ont passé la lecture du catalogue.
Le simulateur
Vos critères de ciblage traduits en plan de prospection, en cinq minutes.
À partir de vos sources
Joindre l’interlocuteur métier plutôt que le standard.
Le responsable métier avant le dirigeant
Dans une entreprise qui embauche, la personne qui ressent le problème est le responsable du recrutement ou le responsable de l’exploitation. Dans un organisme de formation, c’est la direction pédagogique. Le dirigeant arrive après.
Une cascade, un candidat à la fois
L’enrichissement démarre avec le premier candidat classé, et seulement celui-ci. Le verdict revient par webhook. En cas d’échec, le candidat est retiré de la liste, et le suivant est traité la nuit suivante. Enrichir d’un coup les cinq contacts d’une entreprise multiplie la facture pour un seul e-mail utile.
Vérifier au-delà du verdict du fournisseur
Les verdicts acceptés sont DELIVERABLE et HIGH_PROBABILITY. Ils ne suffisent pas. Sur un relevé, 18 % des e-mails déclarés valides ont été écartés, car le domaine ne correspondait ni à l’entreprise ni au dirigeant. Une adresse techniquement valide peut en effet appartenir à quelqu’un d’autre.
// Le verdict arrive par webhook, pour un seul candidat a la fois.
const ACCEPTES = ["DELIVERABLE", "HIGH_PROBABILITY"];
const WEBMAILS = ["gmail.com", "hotmail.fr", "orange.fr"];

function suite(candidat, verdict, entreprise) {
  if (!ACCEPTES.includes(verdict.statut)) {
    // Candidat retire, le suivant repart la nuit suivante.
    return { action: "retirer", replanifier: true };
  }
  const domaine = verdict.email.split("@")[1].toLowerCase();
  const coherent = domaine === entreprise.domaineSite
                 || WEBMAILS.includes(domaine);   // beaucoup de TPE sont sur webmail
  return coherent
    ? { action: "accepter", email: verdict.email }
    : { action: "ecarter", motif: "domaine_sans_rapport" };
}
Les webmails restent acceptés en connaissance de cause : beaucoup de très petites entreprises n’ont pas d’adresse à leur nom de domaine, et les exclure revient à supprimer une part de la cible. Lorsque rien de nominatif ne ressort, la fiche Google Maps fournit plus d’adresses exploitables que le site de l’entreprise. La recherche web, en revanche, renvoie souvent l’adresse de la mairie de la commune, qu’un contrôle du modèle écarte avant la mise en file.
Deux lots donnent une idée du rendement : 79,3 % d’e-mails trouvés sur un lot de 1 619 profils enrichis, 60,0 % sur un lot de 933 profils. FullEnrich annonce publiquement environ 84 % pour les e-mails en zone EMEA. Nous n’avons pas mesuré ce qui explique l’écart entre les deux lots.
- Annonce publique FullEnrich, zone EMEA84 %
- Lot de 1 619 profils enrichis79,3 %
- Lot de 933 profils enrichis60,0 %
Part des profils soumis pour lesquels une adresse a été fournie, avant le contrôle de cohérence du domaine.
Personnaliser chaque e-mail sans rien inventer.
Ce que l’IA adapte, et ce qu’elle a interdiction d’affirmer
Le modèle remplit les trous dans un gabarit. Le corps est découpé en blocs numérotés : deux ou trois sont adaptés, les autres sont recopiés mot pour mot, balises comprises.
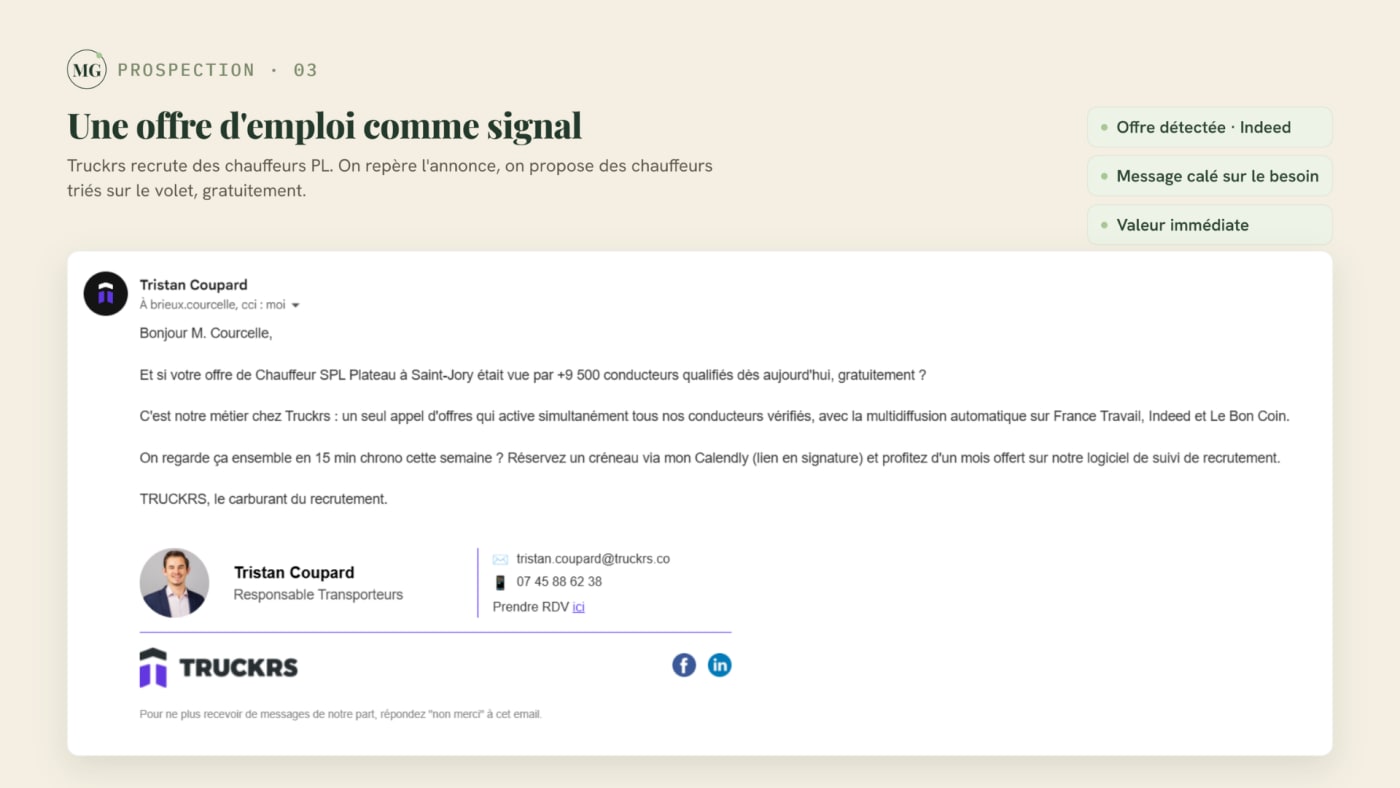
Voici ce qu’il adapte : la raison sociale du registre devient un nom d’usage (« SOCIÉTÉ D’EXPLOITATION DU GARAGE X » devient « Garage X »), la civilité est déduite, l’intitulé de poste est raccourci, les accents sont rétablis, et la référence client la plus proche du destinataire est choisie : un client de la même école quand elle est connue, sinon du même pays.
Ce qui lui est interdit : affirmer un fait non vérifié, comme l’ancienneté d’un dirigeant à son poste. Lorsqu’un contact n’est pas nominatif, une règle de repli impose de s’adresser à l’entreprise, avec l’interdiction explicite d’inventer un nom de personne.
{
  "bloc_2_appel": {
    "adaptable": true,
    "entree": "RAISON SOCIALE REGISTRE + dirigeant si connu",
    "regles": [
      "retirer les formes juridiques et les prefixes d exploitation",
      "casse naturelle, sigles de 2 ou 3 lettres laisses en majuscules",
      "retablir les accents absents du registre",
      "contact non nominatif -> s adresser a l entreprise, nom de personne interdit"
    ]
  },
  "bloc_4_preuve": {
    "adaptable": true,
    "ordre_de_choix": ["meme ecole", "meme pays"],
    "interdiction": "affirmer un fait non present dans les donnees du prospect"
  },
  "bloc_5_signature": { "adaptable": false, "contient": "desabonnement en clair" }
}
Un modèle par tâche
L’objet et le corps sont produits par deux appels distincts, avec deux modèles de taille différente. Un modèle rapide suffit pour l’objet ainsi que pour les reformulations courtes. Le corps et les verdicts demandent davantage. Nous avons testé un modèle lourd pour remplir un gabarit : résultat, des dépassements de délai et des erreurs de quota.
L’IA sert aussi à réparer les données historiques. Sur une liste de 7 900 contacts reprise d’un ancien outil, elle a modifié 27 % des formules d’appel : genre inversé, prénom manquant, encodage cassé. En cas de doute, elle bascule sur une formule neutre.
Le contrôle avant envoi
Un garde-fou vérifie, juste avant l’envoi, que l’objet existe, que le corps existe et qu’il contient le lien attendu.
Rien ne vérifiait alors le contenu avant l’expédition.
Envoyer sans griller son domaine.
Sur les campagnes à froid, les e-mails partent de boîtes réparties sur des domaines secondaires. Le domaine principal du client n’envoie rien. Un domaine .com coûte 11,08 $ par an chez Porkbun au tarif public, ce qui rend cette précaution peu coûteuse face au risque.
Rythme et rotation
Un domaine neuf subit une chauffe sur Smartlead pendant deux à trois semaines. Les envois démarrent à 5 par boîte et par jour, puis montent à 20 à 25 par boîte et par jour en régime établi. Trois boîtes sont utilisées par domaine. Entre deux envois, une pause aléatoire de 150 à 180 secondes est appliquée. En production, un compte tourne sur 4 boîtes pour 20 envois par jour, un autre sur 7 boîtes pour 5 salves de 14 envois. Le score Mail-tester des boîtes se situe entre 9 et 10 sur 10, et nous avons relevé zéro passage en spam à ce jour.
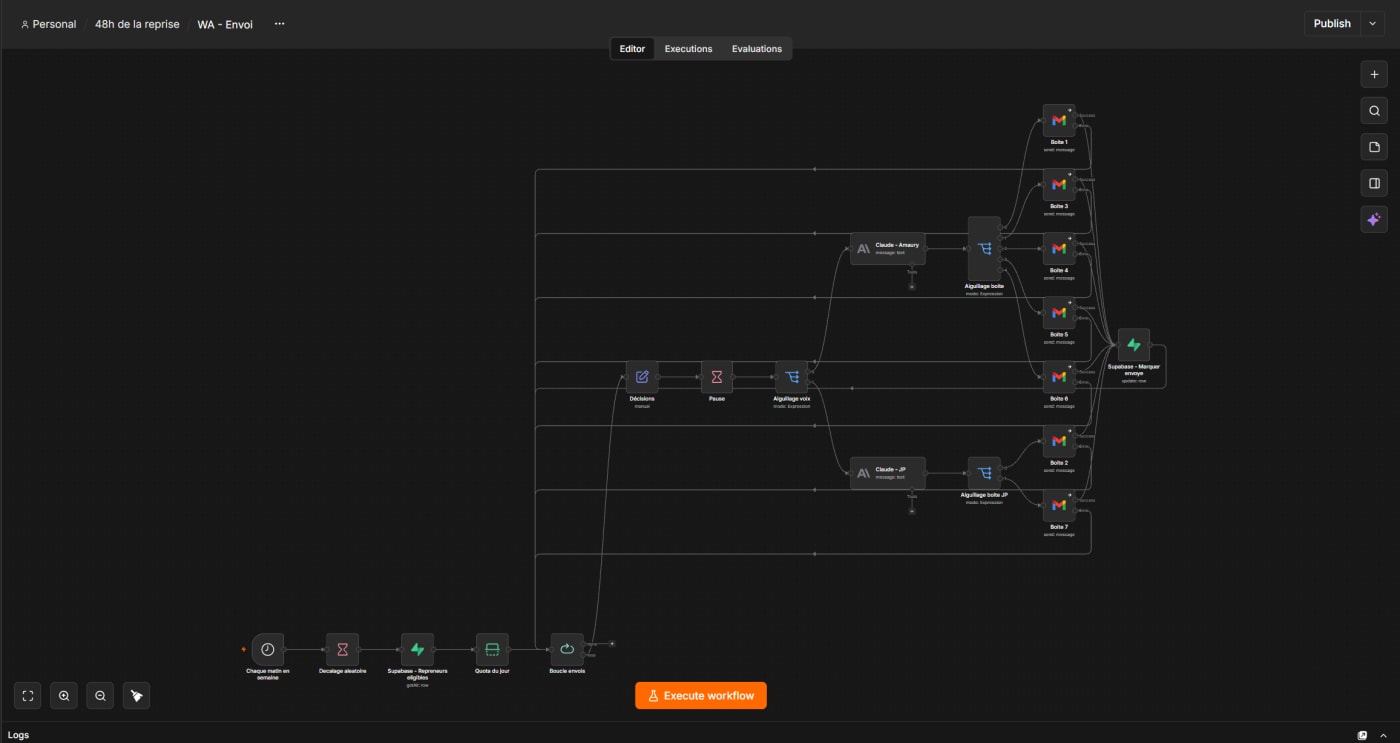
Cette contrainte de débit détermine tout le dimensionnement commercial. À 20 envois par boîte et par jour, sur 21 jours ouvrés, avec 2 e-mails par prospect (en comptant la relance), une boîte peut traiter 210 prospects par mois. Le nombre de boîtes par palier se déduit de ce calcul.
Sur un compte, 1 023 e-mails ont été envoyés du 28 juillet au 24 août 2026, avec 13 bounces sur 560 premiers envois, soit 2,3 %, pour un seuil d’alerte usuel situé à 3 %. Ce taux mesure la qualité de la liste, et non la réputation de l’expéditeur : il ne révèle rien sur la possibilité d’augmenter le débit.
Relevé sur un compte, du 28 juillet au 24 août 2026.
La relance dans le même fil
La relance part dans le même fil de discussion, depuis la même boîte, et passe avant les nouveaux contacts dans la file du jour. Les cadences diffèrent selon les comptes : J+7 puis J+5 avec deux relances maximum sur l’un, J+5 avec une relance unique sur un autre, J+7 avec une relance unique sur le troisième.
Quatre garde-fous sont communs.
- La séquence s’arrête dès qu’une réponse ou un rendez-vous est enregistré.
- Un contact ne reçoit pas deux messages le même jour.
- Le compteur d’envois est relu en base à chaque passage, plutôt que d’être tenu en mémoire.
- Un message d’absence laisse la séquence se poursuivre, alors qu’un refus ou un bounce l’interrompt.
LinkedIn en second canal
L’invitation est envoyée deux jours après l’e-mail, sans note jointe, à raison de 5 à 10 invitations par compte et par jour, avec une pause de 5 à 12 minutes entre chacune. Le message n’est envoyé qu’après acceptation de la connexion, et il renvoie à l’e-mail reçu quelques jours plus tôt. Une réponse sur un canal coupe la séquence sur l’autre, ce qui évite qu’un prospect ayant répondu par e-mail ne reçoive une invitation le lendemain. Ce plafond de 5 à 10 est un choix de prudence de notre part, et non une limite mesurée de la plateforme. Zéro blocage de compte constaté à ce jour.
Lire les réponses : six cas, six traitements.
C’est l’étape où la plupart des campagnes perdent leur valeur. Une boîte de réception non triée mélange des choses qui n’ont rien à voir entre elles. Sur un compte, le pipeline a enregistré 140 messages reçus : 77 messages d’absence, 28 sans type attribué par la classification automatique, 13 refus, 13 bounces, 9 typées « réponse ». Le comptage manuel des boîtes a identifié 14 réponses humaines intéressées. Annoncer 140 réponses serait malhonnête ; s’en tenir aux 9 de la classification automatique serait erroné dans l’autre sens, puisque 28 messages n’ont pas reçu de type.
- Messages d’absence 77
- Sans type attribué 28
- Refus 13
- Bounces 13
- Typées « réponse » 9
Types posés par la classification automatique sur l’ensemble des messages reçus sur le compte.
Le code rapproche, l'IA classe
Notre première version confiait tout au modèle, y compris le rapprochement entre un message et un contact. Sur trois jours de boîte, elle a requis 90 appels pour 4 correspondances. Désormais, le rapprochement s’effectue en code, par l’adresse d’expédition ou par l’identifiant de fil, et les réponses automatiques sont éliminées par un filtre sur l’objet avant tout appel au modèle. Le modèle ne voit que ce qui reste.
// 1. Les automatiques sortent avant le modele : zero appel paye pour rien.
const AUTO = /^(re\s*:\s*)?(absence|out of office|automatic reply|notification)/i;
if (AUTO.test(message.objet)) return { classe: "absence", appelModele: false };

// 2. Rapprochement en code : adresse, puis identifiant de fil.
const contact = parAdresse(message.from) || parFil(message.threadId);
if (!contact) return { classe: "hors_campagne", appelModele: false };

// 3. Le modele tranche sur le texte restant.
const classe = await classer(message.texte);
const SUITE = {
  interesse: { stop: true,  notifier: true },
  refus:     { stop: true,  desinscrire: true },
  absence:   { stop: false },
  antispam:  { stop: false, debloquer: true },  // personne n a lu le message
  bounce:    { stop: true,  sortirDeLaFile: true },
  client:    { stop: true,  horsCampagne: true }
};
Les six traitements suivent cette table.
- La réponse intéressée arrête la séquence et est transmise au commercial.
- Le refus déclenche la désinscription.
- Le message d’absence laisse la séquence se poursuivre.
- Un défi antispam de type Mailinblack signifie que le message n’a pas été lu : il est débloqué et la séquence reprend.
- Le bounce sort le contact.
- Le message d’un client existant est classé hors campagne.
Les spams et les archives sont lus en plus de la boîte principale, et le texte de chaque message est conservé pour vérifier le classement a posteriori.
La boîte du client reçoit aussi ses clients
Détail qui a faussé nos premiers tableaux de bord : la boîte d’envoi d’un client reçoit aussi les messages de ses clients et de ses fournisseurs. Sans classe dédiée pour ces messages, ils gonflent artificiellement le taux de réponse affiché. La classe « client existant » existe pour cette seule raison.
Combien coûte une prospection IA.
Tarifs publics relevés le 12 octobre 2026 sur les pages des éditeurs. Les montants en dollars sont ceux affichés par l’éditeur.
| Poste | Outil | Tarif public au 12 octobre 2026 |
|---|---|---|
| Offres d’emploi | Apify, misceres/indeed-scraper | 5,00 $ pour 1 000 offres, plan Starter |
| Profils LinkedIn | Apify, harvestapi/linkedin-profile-search | 4,00 $ pour 1 000 profils complets |
| Fiches Google Maps | Apify, compass/crawler-google-places | 3,00 $ pour 1 000 lieux |
| E-mail professionnel | FullEnrich | 0,058 $ le crédit à l’entrée (500 crédits pour 29 $ par mois) |
| Lecture de pages web | Jina Reader | Gratuit sans clé, 20 requêtes par minute |
| Orchestration | n8n Cloud Starter | 20 € par mois, facturé à l’année |
| Boîte d’envoi | Google Workspace Business Starter | 6,80 € par utilisateur et par mois |
| Domaine d’envoi | Porkbun, .com | 11,08 $ par an |
| Canal LinkedIn | Unipile | 49 € HT par mois jusqu’à 10 comptes |
| Chauffe de domaine neuf | Smartlead Base | 39 $ par mois |
FullEnrich facture un crédit par e-mail trouvé et zéro lorsque rien n’est trouvé. La nuance a son importance : les e-mails trouvés puis écartés par notre contrôle de domaine sont payés.
Ce que coûte un e-mail rédigé par IA. La rédaction d’un corps consomme environ 3 050 tokens en entrée et de 780 à 1 030 tokens en sortie, raisonnement compris, sur une exécution relevée. Au tarif public de Claude Sonnet 5.5, cela représente de 0,014 $ à 0,016 $ par e-mail. L’écriture n’est donc pas le poste à surveiller.
Où l’argent se perd. Dans l’enrichissement en masse, lorsque l’on paie pour cinq contacts d’une entreprise alors qu’un seul est utilisé. Dans le choix d’un modèle surdimensionné pour une tâche de gabarit, qui ajoute des dépassements de délai aux erreurs de quota. Dans les lots renvoyés en erreur pour crédits insuffisants : chez nous, un lot refusé n’est pas marqué comme traité et revient seul dans la file, ce qui évite de repayer une recherche déjà effectuée. Enfin, dans les e-mails partis vides, qui consomment un crédit, une adresse et une place dans le quota journalier.
Ce que cela produit, et pourquoi vos statistiques mentent.
Les scanners ouvrent et cliquent à votre place
Les passerelles de sécurité des entreprises et des universités ouvrent les e-mails et suivent les liens avant le destinataire. Sur une campagne, 677 clics distincts ont généré 9 sessions avec engagement sur le site. Certains domaines affichent 100 % d’ouverture avec zéro clic côté humain. Un taux d’ouverture élevé sans réponse mesure l’activité des scanners.
Mesurer les réponses et les rendez-vous
Nous avons supprimé le suivi des ouvertures et des clics pour ces campagnes. La mesure repose désormais sur trois éléments : les réponses associées en base, les paramètres UTM et un identifiant du prospect placé dans le lien de réservation. Sur certaines campagnes, le corps de l’e-mail ne contient pas de lien, et la désinscription se fait par simple réponse.
-- Ce que compte le dashboard : des contacts reellement contactes et des
-- reponses humaines rapprochees. Les ouvertures ne figurent pas dans la vue.
select
  c.compte,
  count(*) filter (where e.premier_envoi is not null)  as contactes,
  count(*) filter (where r.type = 'interesse')         as leads,
  count(*) filter (where rdv.id is not null)           as rdv_tenus
from contacts c
left join envois      e   on e.contact_id = c.id
left join reponses    r   on r.contact_id = c.id
left join rendez_vous rdv on rdv.prospect_uid = c.uid   -- identifiant porte par le lien
where e.premier_envoi between date '2026-06-10' and date '2026-10-12'
group by c.compte;
L'identifiant dans le lien
Une partie des rendez-vous provient d’un autre canal que l’e-mail, avec une autre adresse que celle contactée. Sur un compte, 8 rendez-vous ont été tenus : 3 faisaient suite à une réponse par e-mail, 5 ont été pris directement sur Calendly sans réponse préalable. Sans identifiant dans le lien et sans typage des rendez-vous par canal, ces 5 auraient été attribués au hasard ou perdus.
Deux autres relevés nous ont rendus prudents quant à l’attribution. Le gagnant automatiquement désigné par un test A/B d’objet a contredit les chiffres finaux de ce même test, sur environ 1 500 contacts par version, où l’écart relevait du bruit. Lors d’une campagne de réactivation, le suivi au dernier clic n’a attribué qu’une seule inscription, alors que l’outil d’analyse produit mesurait l’effet par cohorte.
Pour estimer ce qu’un tel système donnerait sur votre volume, le simulateur fait le calcul avec vos propres hypothèses.
Construire, acheter un outil ou déléguer.
L’outil en libre-service. lemlist affiche 69 $ par mois pour son offre Email, La Growth Machine 60 € par mois et par identité, Clay 185 $ par mois au palier Launch et 495 $ au palier Growth, tarifs publics relevés le 12 octobre 2026. Ces outils exécutent très bien l’envoi et la séquence. Ce qu’ils ne font pas à votre place, c’est le travail décrit dans les sections 2 à 4 : décider quel signal vaut un contact, écrire les règles d’exclusion, construire la cascade d’enrichissement, régler les six traitements de réponse. Le prix de l’outil est la plus petite partie du budget. Le temps de la personne qui le pilote en est la part la plus importante.
L’agence. Les abonnements affichés par les agences de prospection françaises vont de 980 à 8 000 € par mois, avec des coûts par rendez-vous livré annoncés de 150 à 400 €. Ce sont des tarifs publics et non des devis reçus. Le modèle est rentable lorsque le volume est régulier. Il devient coûteux dès que le signal exploité change fréquemment.
Le système sur mesure. C’est ce que nous installons, et la position commerciale est assumée : abonnement mensuel sans engagement et sans frais d’activation, 390 € HT par mois pour un axe de prospection, deux boîtes d’envoi et 400 prospects analysés et contactés, 990 € HT pour deux axes, six boîtes et 1 200 prospects, 1 790 € HT pour trois axes, douze boîtes et 2 500 prospects. Les paliers incluent la séquence e-mail et LinkedIn avec relance à J+7, un livrable personnalisé par prospect, un tableau de bord de suivi en temps réel et un appel de suivi à la demande. Le traitement des réponses reste chez le client, qui connaît son produit mieux que nous. Un domaine d’envoi supplémentaire avec configuration SPF, DKIM, DMARC et chauffe coûte 75 € HT une fois.
Le point de comparaison que nous utilisons lors des rendez-vous est un commercial B2B en France, estimé à plus de 50 000 € par an, charges comprises. Un système de prospection IA prépare les conversations de vente et laisse l’humain les mener.
Questions fréquentes
C'est quoi la différence entre un agent IA et un pipeline de prospection ?
Un agent décide seul de l'enchaînement de ses actions à partir d'un objectif. Un pipeline fixe l'ordre des étapes à l'avance et appelle un modèle là où un jugement est nécessaire : qualifier un profil, classer des candidats à l'enrichissement, adapter un email, trier une réponse. Nos systèmes sont des pipelines orchestrés dans n8n, avec des appels de modèles à six endroits précis. Ce choix rend chaque exécution reproductible et chaque décision traçable en base.
Quels outils faut-il pour monter une prospection IA ?
En production, nous utilisons Apify pour le scraping (offres d'emploi, profils LinkedIn, fiches Google Maps), les registres publics SIRENE et BODACC pour les listes d'entreprises, Jina Reader pour lire une page web, les modèles Claude, Gemini et Mistral selon la tâche, FullEnrich pour l'email professionnel, n8n pour l'orchestration, Smartlead pour la chauffe d'un domaine neuf et Unipile pour le canal LinkedIn. La liste compte moins que la façon dont les étapes s'enchaînent et dont les échecs reviennent dans la file.
Combien ça coûte par mois, concrètement ?
Le variable est faible : au tarif public relevé le 12 octobre 2026, 5,00 $ pour 1 000 offres d'emploi scrapées sur le plan Starter d'Apify, un crédit FullEnrich par email trouvé à partir de 0,058 $, et de 0,014 $ à 0,016 $ d'IA pour un corps d'email rédigé au tarif de Claude Sonnet 5.5. Le récurrent tient aux boîtes et aux abonnements : 6,80 € par boîte Google Workspace et par mois, 49 € HT par mois pour Unipile. Notre offre d'abonnement démarre à 390 € HT par mois pour un axe, deux boîtes d'envoi et 400 prospects analysés et contactés.
Est-ce que c'est légal au regard du RGPD ?
Nous traitons des données professionnelles, sur la base légale de l'intérêt légitime, avec l'objet du contact annoncé dès le premier message. La désinscription se fait en un clic ou par simple réponse, la suppression est appliquée sur demande, et l'hébergement est européen. À ce jour, nos systèmes n'ont fait l'objet ni d'un contrôle ni d'un contentieux.
Est-ce que l'IA remplace un commercial ?
Elle prend en charge le travail de liste, de recherche et de rédaction répétitive. La conversation reste humaine : chaque réponse manifestant un intérêt part à un commercial, qui mène l'échange. Nous livrons le lead et le client traite la réponse, parce qu'il connaît son produit et ses clients mieux que nous.
Votre stratégie de prospection, générée pour vous.
- Site web
- Réseaux sociaux
- Client type